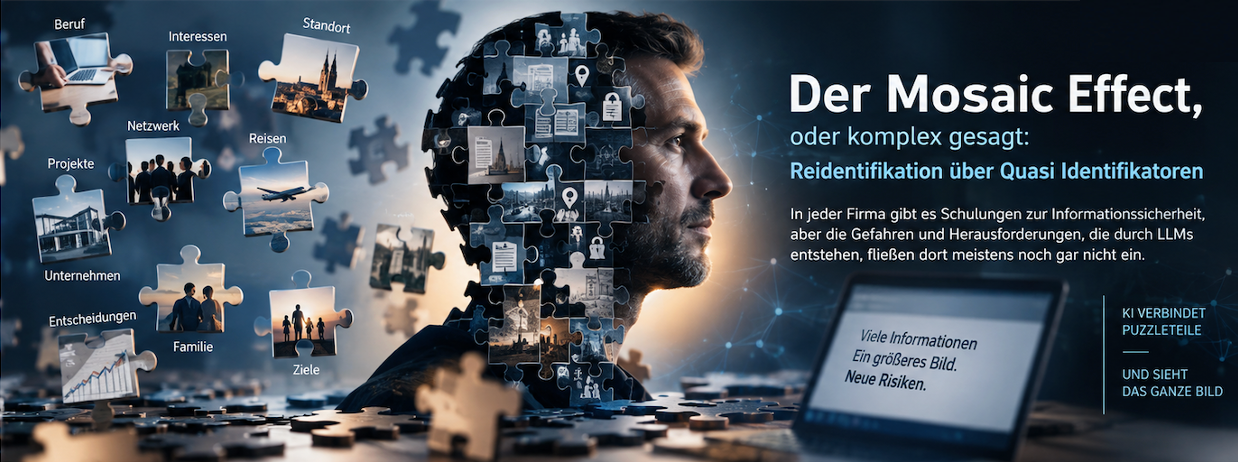
In jeder Firma gibt es Schulungen zur Informationssicherheit. Aber die Gefahren und Herausforderungen, die durch LLMs entstehen, fließen dort meistens noch gar nicht ein.
„Ich habe den Firmennamen doch gar nicht genannt.“
Dieser Satz wird in Zukunft deutlich weniger beruhigend sein, als wir heute glauben.
Nehmen wir ein Beispiel. Ich frage eine KI: „Ein Halbleiterhersteller in Regensburg hat ein Problem in der Epitaxie. Welche Ursachen könnten dahinterstecken?“ Kein Firmenname, kein Ansprechpartner, keine Kundennummer. Also anonym?
Wahrscheinlich nicht. Denn die nächsten Fragen liegen auf der Hand. Welche Halbleiterhersteller gibt es in Regensburg, welche davon betreiben Epitaxie, welche Materialien verarbeiten sie, welche Stellenanzeigen wurden zuletzt veröffentlicht, wer schreibt auf LinkedIn über diese Technologien. Aus „ein Halbleiterhersteller“ wird ziemlich schnell ein konkretes Unternehmen, ohne dass der Name ein einziges Mal gefallen ist.
Das Prinzip ist nicht neu
Das US-amerikanische Office of Management and Budget hat den Mosaic Effect schon 2013 in seiner Open Data Policy beschrieben: Eine einzelne Information stellt für sich kein Risiko dar, in Kombination mit anderen verfügbaren Informationen aber sehr wohl. Behörden müssen deshalb vor jeder Veröffentlichung mitdenken, was sonst noch öffentlich zugänglich ist, in welchem Medium und aus welcher Quelle auch immer.
Seit 2018 steht derselbe Gedanke im amerikanischen Evidence Act, also im Gesetz. Und NIST, das amerikanische Normungsinstitut, beschreibt in seiner Publikation zur Deidentifikation von Datensätzen (SP 800-188) die technische Seite dazu. Jahrzehntelang galt das Entfernen von Namen und Kennnummern als ausreichend, seit den Neunzigern zeigt die Forschung das Gegenteil. Dort steht auch ein Satz, der mir seit Wochen nicht aus dem Kopf geht: Letztlich kann jede Information potenziell identifizierend sein.
In den USA ist das seit über zehn Jahren Verwaltungspraxis. In unseren Firmenschulungen kommt es bisher nicht vor.
Quasi Identifikatoren
Damit sind Informationen gemeint, die für sich genommen niemanden eindeutig identifizieren, in Kombination aber sehr wohl. Standort, Branche, Unternehmensgröße, eingesetzte Technologie, Maschinentyp, Produktionsverfahren, Projektzeitraum.
„Softwareunternehmen mit 20 Entwicklern“ ist unspezifisch. „Softwareunternehmen mit rund 20 Entwicklern in der Region Regensburg, starkem Halbleiterfokus und einem eigenen Recipe Management System“ ist eine völlig andere Informationsqualität.
Falls beim Lesen jemand gemerkt hat, dass diese Beschreibung auf meinen eigenen Arbeitgeber passt: genau das ist der Punkt. Ich habe nichts verraten, was nicht ohnehin öffentlich wäre. Trotzdem wird der Kreis sehr klein.
Was sich durch LLMs ändert
Solche Zusammenhänge könnte ein Mensch auch herstellen. Er müsste dafür suchen, lesen, vergleichen und Quellen miteinander verbinden. Für KI Systeme ist genau das eine der großen Stärken, auch wenn die Informationen unterschiedlich formuliert sind und aus verschiedenen Zusammenhängen stammen.
Mit Agenten wird daraus ein Prozess. Die Webseite liefert Information A, eine Stellenanzeige B, LinkedIn C, ein Geschäftsbericht D, ein Patent E, ein Forschungsprojekt F. Keines dieser Puzzleteile muss geheim sein. Interessant ist das Bild, das daraus entsteht.
Und eine KI kann nicht nur speichern, sie kann schlussfolgern. Aus vorhandenen Informationen entstehen neue, die niemand je angegeben hat. Diese Person arbeitet vermutlich in einer Führungsposition. Dieses Unternehmen hat womöglich ein Problem in einem bestimmten Produktionsbereich. Keine dieser Aussagen muss irgendwo als Datenbankfeld existieren. Sie entsteht durch Interpretation, und aus einer Sammlung von Daten wird so ein Modell eines Unternehmens.
Der ehrliche Einwand
An dieser Stelle kommt berechtigt der Einwand: Wenn ich alles weglasse, bekomme ich auch keine brauchbare Antwort mehr.
Das stimmt, und es ist kein Nebeneffekt, sondern systematisch. NIST beschreibt genau diese Abwägung: Je stärker man deidentifiziert, desto ungenauer werden die Daten. Eine KI, die nur „ein industrieller Beschichtungsprozess“ kennt, hilft bei einem Epitaxieproblem nicht weiter.
Es gibt hier also keine saubere Lösung, sondern eine Abwägung, die niemand pauschal für alle Fälle treffen kann. Der Unterschied liegt darin, ob man sie bewusst trifft oder gar nicht erst bemerkt, dass es eine gibt.
Was daraus für Schulungen folgt
Aus „Kunde Müller GmbH“ einfach „Kunde A“ zu machen ist keine Anonymisierungsstrategie. Standort, Technologie, Anlagentyp und Zeitraum wirken zusammen genauso identifizierend. Die sinnvollere Frage vor einer Eingabe lautet deshalb: Wie viel Detail braucht die Aufgabe wirklich, und welche anderen Informationen kennt das System zu diesem Sachverhalt möglicherweise schon?
Dazu kommt der Punkt, den ich am wenigsten diskutiert sehe. Heute Prompt A, morgen Dokument B, nächste Woche Meetingnotiz C, später Zugriff auf SharePoint, Mail, CRM und Ticketsystem. Jede einzelne Freigabe kann sinnvoll sein. NIST weist genau darauf hin, dass sich die Informationspreisgabe über mehrere Veröffentlichungen aufsummiert, auch wenn jede für sich klein bleibt. Irgendwann besitzt das System genügend Puzzleteile für ein Bild, das niemand bewusst als Ganzes freigegeben hat.
Unsere Regeln fragen bisher: Ist diese einzelne Information vertraulich? Sie müssten zusätzlich fragen: Was lässt sich daraus zusammen mit anderem ableiten? Das ist schwieriger zu vermitteln, aber genau darin liegt die neue Aufgabe.
Die Spannung, über die kaum jemand spricht
Gleichzeitig machen wir unsere Informationen bewusst maschinenlesbarer. Wir optimieren Webseiten für KI Systeme, bauen APIs, stellen MCP Schnittstellen bereit, strukturieren Produktinformationen, veröffentlichen Knowledge Bases.
Die Marketingfrage lautet: Wie sorgen wir dafür, dass KI unser Unternehmen kennt?
Die Frage aus der Informationssicherheit müsste parallel lauten: Was kann KI dadurch über uns herausfinden, was wir nie explizit veröffentlicht haben?
Ich sitze beruflich auf der ersten Seite und finde die zweite Frage trotzdem berechtigt. Bisher höre ich sie deutlich seltener.
Meine Faustregel
Wir sollten bei der Nutzung von KI nicht nur darauf achten, ihr keine Geheimnisse zu verraten. Wir sollten auch darauf achten, ihr nicht genügend Puzzleteile zu geben, damit sie das Geheimnis selbst zusammensetzt.
Bei Unternehmen ist das der offensichtliche Fall. Bei Personen finde ich ihn fast interessanter, weil dort über Jahre und in kleinen Portionen ein Bild entsteht, das niemand je bewusst preisgegeben hat. Darüber schreibe ich im nächsten Beitrag.